 400-180-0719
语音质检怎么做?从抽检 5% 到全量复盘的落地方法
绝大多数门店的语音质检做不起来,不是因为没工具,而是因为抽检这件事本身有天花板。
传统做法的循环是:定标准 → 抽 5% 录音 → 听 → 打分 → 出报告 → 门店整改。这个循环跑到第三个月通常会死掉,原因有三个,而且都不是态度问题:
1. 覆盖率太低,等于没有。 5% 的抽检率,意味着 95% 的接待从未被看过。员工很快会得出一个理性结论:"只要不被抽到就行。"
1. 标准各写各的。 五个督导五套打分表,同一条录音能得 62 分也能得 88 分,门店不服,质检变成扯皮。
1. 结果不闭环。 报告发出去,没有整改动作、没有复查、没有和培训挂钩,三个月后同样的问题还在。
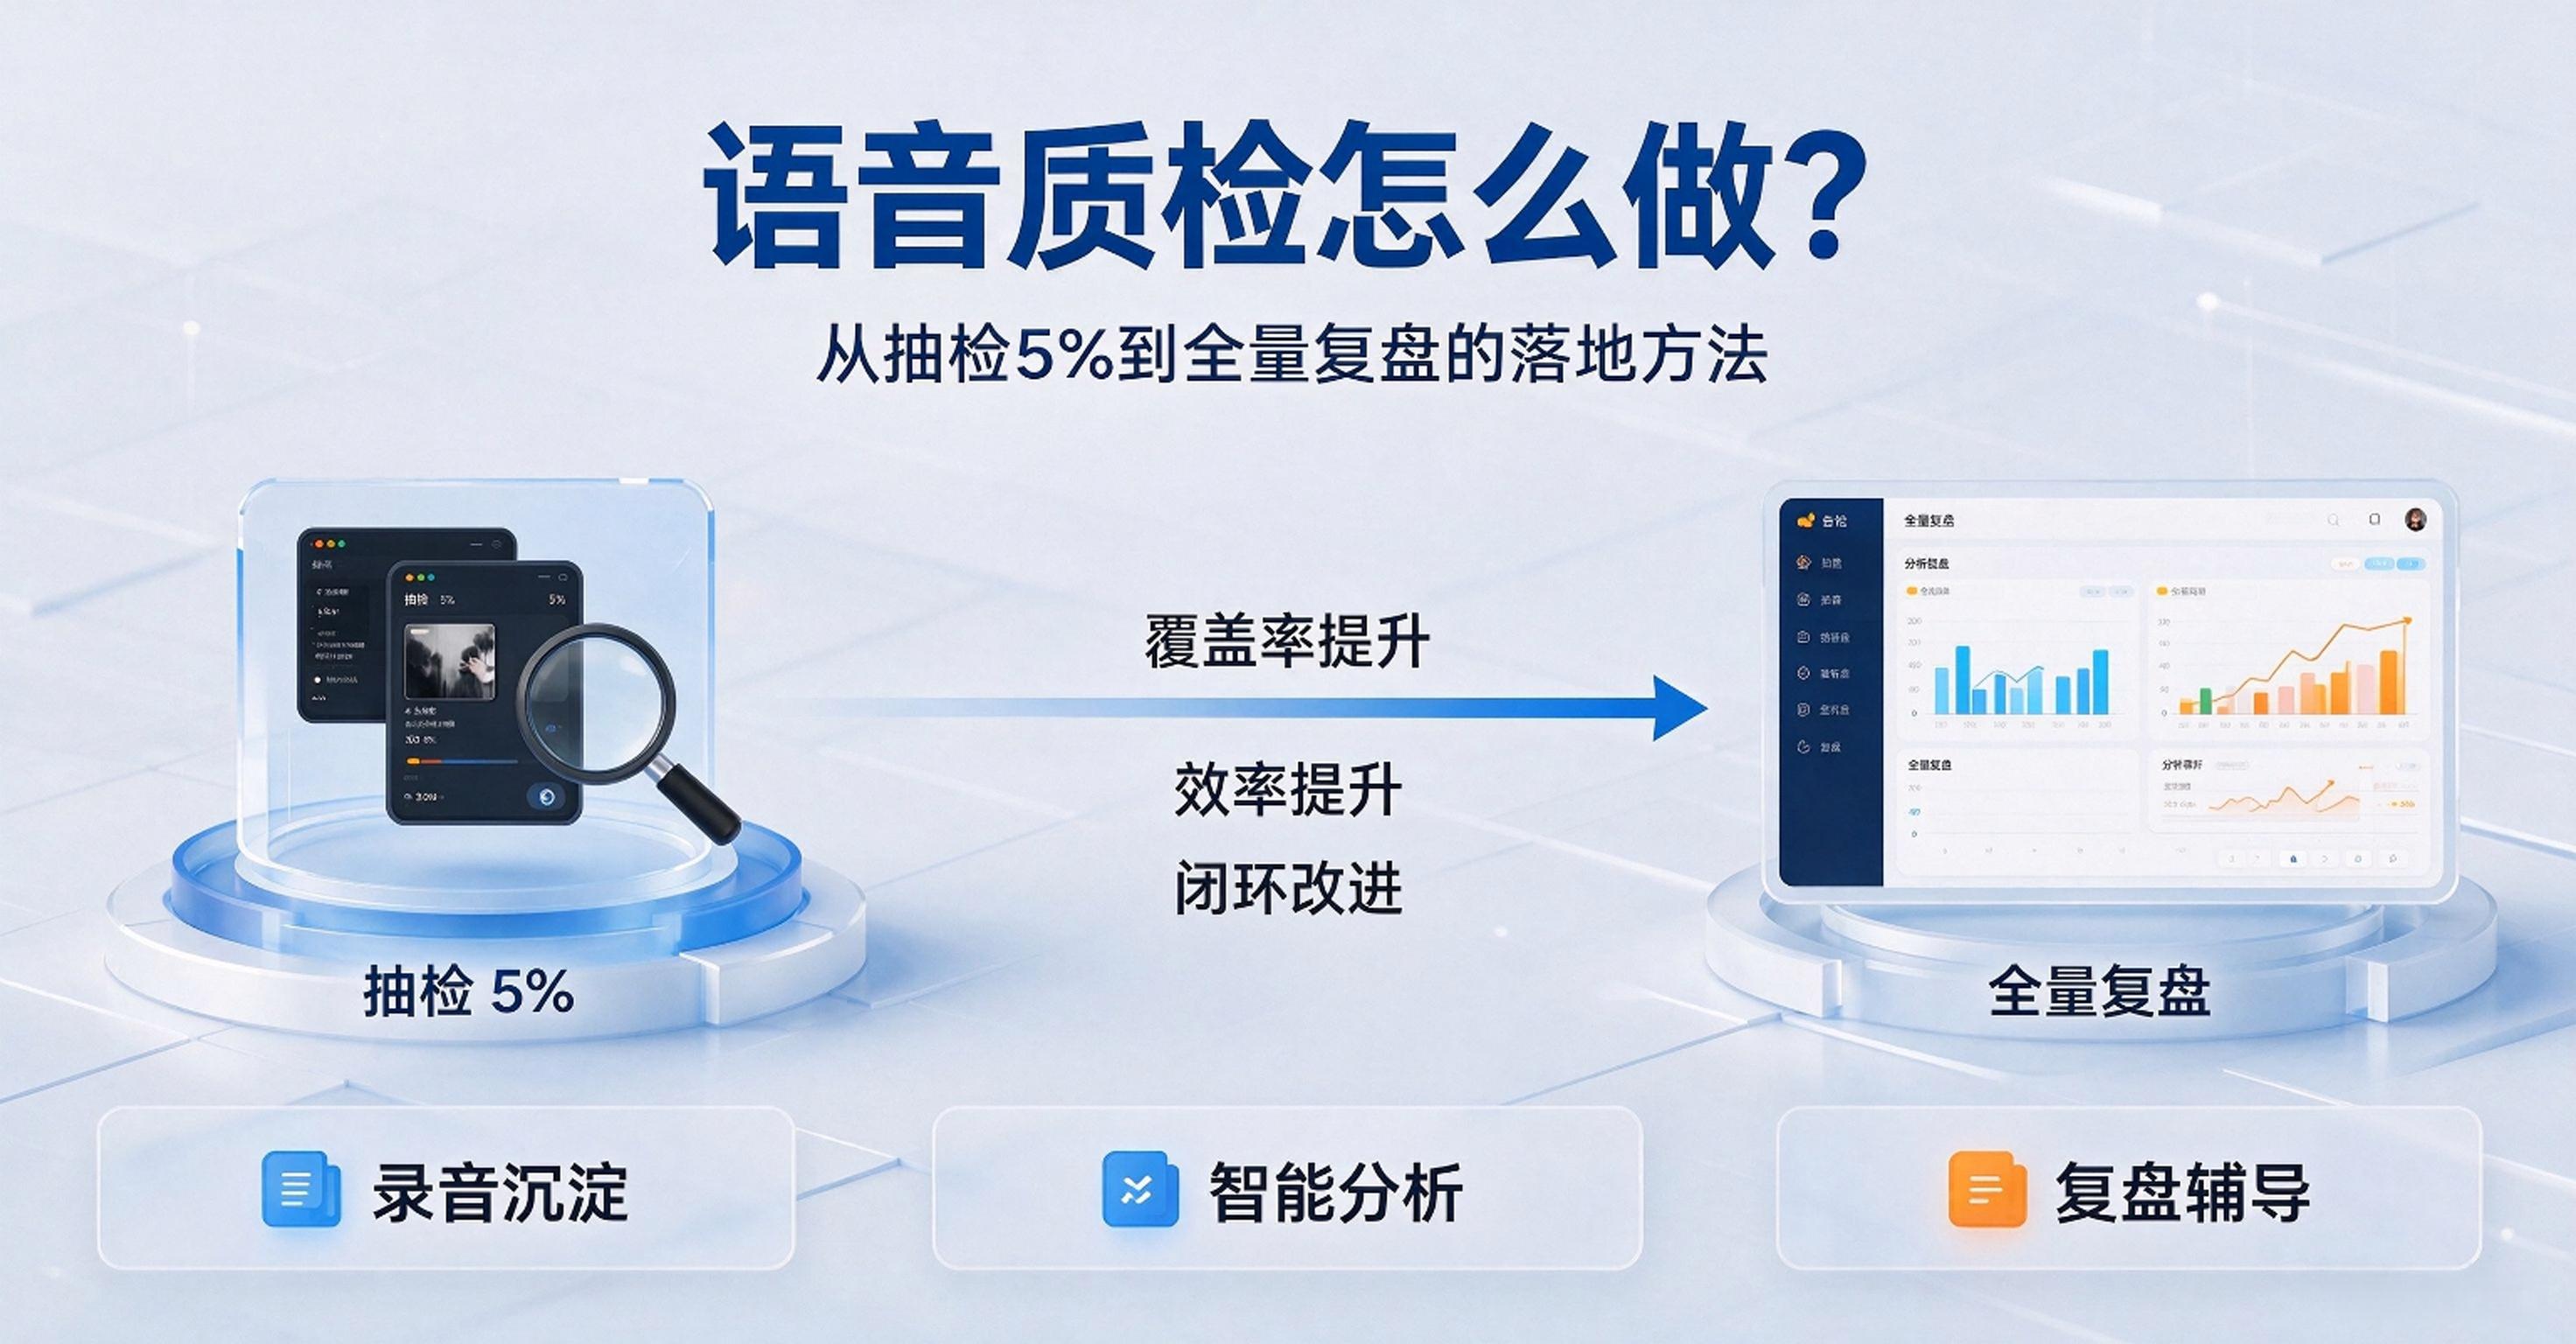
解法不是"抽得更多",是把质检从"人找问题"改成"机器找人要复核的问题"。 这一步跨过去,覆盖率能从 5% 到 100%,而人力投入反而下降。承载这套流程的是 语音质检与销售复盘平台——硬件只负责录音,质检链路的效率差异全在平台侧。
一、抽检 vs 全量:算一笔人力的账
假设 50 家门店、每店每天 20 段有效接待、每段 8 分钟:
| 传统抽检 5% | 全量 AI 初筛 + 人工复核 20% | |
| 每天录音量 | 1000 段 / 133 小时 | 1000 段 / 133 小时 |
| 需人工听的数量 | 50 段(6.7 小时) | 200 段(26.7 小时)← 但只复核被标记的 |
| 实际人工耗时 | 约 20 小时(听 + 打分 + 写评语) | 约 6–8 小时(只看 AI 标出的问题点片段) |
| 覆盖率 | 5% | 100%(20% 深度复核) |
| 问题发现数量 | 基准值 100 | 约 320(示例) |
表中耗时与倍数均用于说明结构差异。实际取决于质检项数量与录音长度。
差别的关键在于:人工不再从头听,只复核 AI 挑出来的 30 秒片段。 一段 8 分钟的录音,AI 标出"未报价""未邀约试驾""竞品提及未应答"三处,人工只需要听这三处并判断对错——从"听 8 分钟"变成"听 90 秒"。
这就是全量质检在经济上可行的唯一原因。听全部录音从来都不可行,也不需要。
二、质检体系四件套(先有标准,再谈工具)
工具只负责执行标准。标准没定清,上什么系统都是浪费。
① 质检项分三层,权重完全不同
| 层级 | 定义 | 处理方式 | 举例 |
| 红线项 | 触碰即重大风险 | 一票否决,当日通报 | 承诺无法兑现的政策、私自降价、辱骂客户、未告知录音 |
| 关键项 | 直接影响成交 | 计分,占 60%–70% 权重 | 需求挖掘、竞品应对、报价、邀约下一步 |
| 加分项 | 优秀但非必须 | 计分,占 20%–30% | 主动提供增值信息、复述确认、情绪安抚 |
红线项不要超过 5 条。 见过一家公司列了 23 条红线,结果每条都不红线了——督导自己也记不住。
② 评分卡:6 个维度、100 分制
| 维度 | 权重 | 关键判断点 |
| 开场与破冰 | 10 | 是否自我介绍、是否说明录音、是否建立信任 |
| 需求挖掘 | 25 | 是否提问(而非只介绍)、是否问到决策人与预算 |
| 产品讲解 | 20 | 是否匹配客户需求、是否讲清差异点、有无错误表述 |
| 异议处理 | 20 | 是否正面回应、是否给出证据、有无回避 |
| 成交推进 | 20 | 是否报价、是否给出明确的下一步、是否留资 |
| 服务规范 | 5 | 用语、情绪、结束语 |
打分只到"有/无/部分"三级,不要 1–10 分。 五级以上的打分,不同人之间的标准差会大到让数据失去意义。
③ 样本策略:不是随机抽,是按风险抽
全量之后仍然要做人工抽样,但逻辑变了——从"随机抽"变成"按风险优先级抽":
1. 低分录音全看(AI 打分 < 60)
1. 红线命中全看
1. 新人(入职 3 个月内)加密抽
1. 销冠录音反而不看分数,看内容——用来提炼话术,不是找问题
④ 申诉机制:没有它,质检一定被抵触
门店可以申诉,申诉由第三方(不是原质检员)复核,申诉成功要修正分数且计入质检员准确率。
这条看起来是给门店的权利,实际是给质检体系装了个校准器——没有申诉,质检员会逐渐漂移,标准半年就废了。
三、全量质检的落地五步
第 1 步:定义红线与关键项(1 周)
拉上业务负责人,只做一件事:把"什么叫做得不好"写成能被机器判断的句子。
反例:"服务态度要好"——无法判断。 正例:"客户提出价格异议后,销售未做任何回应即继续介绍产品"——可判断。
DuDuAgent 这类 会话智能引擎 的价值在这里:它能把自然语言描述转成可执行的识别规则,不需要写代码。
第 2 步:AI 初筛(系统自动,无需人力)
全量转写 + 按规则打标。这一步的输出不是"分数",是问题清单:哪一段、第几分钟、命中了哪条规则、原文是什么。
第 3 步:人工复核 20%
只复核被标记的片段。复核结果有三个作用:确认问题、修正 AI 误判、给 AI 提供反馈样本。
AI 误判率要监控。 上线首月误判率 20%–30% 是正常的,三个月内应降到 10% 以下。降不下来的,多半是规则写得不够具体,而不是模型不行。
第 4 步:周会复盘(这是最容易被跳过的一步)
每周固定 1 小时,只看三张表:
1. 红线命中榜(谁、哪家店、什么行为)
1. 关键项得分分布(哪个维度整体偏低)
1. 最佳实践片段(本周得分最高的 3 段录音,当场播放)
第三张表是让质检从"抓错"变成"学好的"关键。只讲问题的质检会,三个月后没人愿意开。
第 5 步:话术沉淀与训练
把高分片段拆成可复用的话术卡片,进培训库;把低分场景做成情景演练题。这一步做完,质检才真正影响业绩,而不只是影响考核。
数据侧可以交给 语音数据报表与业务看板 自动出,不必每周手工汇总。
四、三个行业的质检重点差异
同一套评分卡不能套所有行业,重点维度要调权重:
| 行业 | 权重最高 | 最容易出问题的地方 | 建议 |
| 汽车 4S | 需求挖掘 + 异议处理 | 竞品对比时贬低对手、试驾邀约缺失 | 把"邀约试驾"设为关键项而非加分项 |
| 地产案场 | 产品讲解 + 成交推进 | 销讲漏项、承诺学区/规划 | 销讲标准化,漏项直接扣关键项分 |
| 口腔/医美 | 服务规范 + 风险告知 | 过度承诺疗效、未告知风险 | 风险告知设为红线项 |
行业方案的差异可以参考 汽车门店、地产案场、零售导购 三个页面,里面的质检项设置已经按行业拆好。
五、从质检到训战:一个零售连锁的示例
某零售连锁(48 家店、320 名导购)的三个月路径,以下数据为示例,用于说明节奏:
| 阶段 | 时间 | 动作 | 结果(示例) |
| 1 | 第 1 月 | 定义 4 条红线 + 6 维度评分卡,10 家店试点全量质检 | 质检覆盖率 5% → 100%(试点店) |
| 2 | 第 2 月 | 全量铺开,人工复核 20%,周会制度建立 | 红线命中率下降 42%;店长周均耗时从 9 小时降到 3 小时 |
| 3 | 第 3 月 | 高分片段拆话术卡,纳入新人培训 | 新人首月达标率 38% → 71%;客单价提升 6.4% |
三个观察:
1. 第一个月不要考核。 只通报、不罚款。带着罚款上线的质检,数据一定失真——员工会想办法绕开录音。
1. 店长时间必须降下来。 如果全量质检让店长更忙,一定推不动。省下来的时间要明确告诉他们能干什么。
1. 话术卡比分数有用。 店长不关心平均分,关心"我这周该让谁学哪句话"。
汽车行业的同类路径可以看 汽车门店智能工牌案例——那条案例的核心不是"上了设备",而是把评估从人工抽查改成 AI 全量初筛,评估覆盖率的变化是最有说服力的部分。
六、四个常见误区
误区 1:先把系统买了,标准慢慢想。 反了。标准先行,工具才有落点。没有评分卡的系统,只能存录音。
误区 2:追求 100% 人工复核。 经济上不成立。全量的价值在于"全部被看见",不在于"全部被人听过"。人工只需覆盖风险最高的那部分。
误区 3:把质检做成扣分表。 只扣分不加分的体系,三个月内必然被抵触到失效。加分项和最佳实践是让它活下去的部分。
误区 4:AI 打分了就不用管了。 AI 负责覆盖率和一致性,人负责判断和纠偏。两者任何一个缺席,质检都会退化成形式。
七、常见问题
Q1:语音质检和人工听录音,本质区别是什么? A:不是"机器代替人听",是把人工从"听"解放到"判断"。机器做全量筛和定位,人只判断被标出的片段,覆盖率从个位数到 100% 的同时,人力反而省了。
Q2:转写不准怎么办?方言、口音能识别吗? A:这是质检能不能用的前提条件。选型时要用自己门店的真实录音去测,别用厂商给的样音。测三项:方言识别率、专业术语识别率、多人同时说话的分离能力。
Q3:员工知道被全量质检,会不会更抵触? A:会,所以上线顺序很重要:先明示告知、前三个月不挂钩罚款、把质检结果先用于帮助他们(而不是考核他们)。
Q4:一套质检体系多久能跑起来? A:单店试点 2–4 周能出第一版评分卡;全量铺开通常需要 1–2 个月,其中标准打磨占一半时间。想快,就先在一个业态、一个区域做透。
Q5:质检结果怎么和培训连起来? A:三个动作——低分场景做演练题、高分片段做话术卡、维度短板做专项课。质检不连培训,就只是考核工具,价值少一半。