 400-180-0719
语音工牌转写准确率有多高?影响识别质量的 6 个变量
评估语音工牌时,几乎所有客户都会问同一句话:"转写准确率多少?"。这个问题需要一个更诚实的回答方式——因为准确率不是一个固定数字,而是一组变量的函数。这篇把变量逐个拆开。
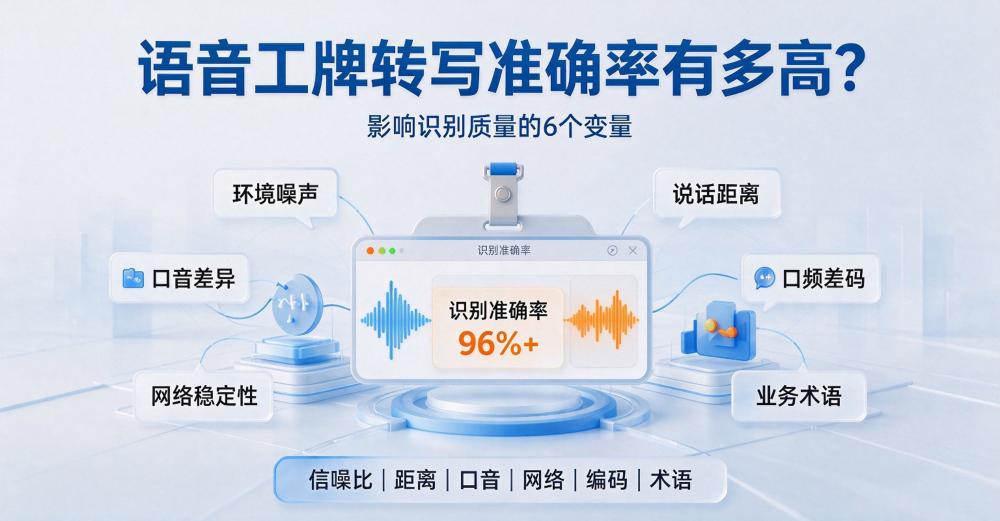
先给结论:在安静门店环境、1–3 米正常接待距离下,主流一线产品的转写准确率可以达到 96% 以上;嘈杂环境会下降 5–10 个百分点;强方言场景可能降到 85–90%。但"96% 够不够用"取决于你用转写做什么——做全文精读,96% 不够;做关键词命中、话术核查、会话分类,95% 就已经完全够用,因为分析引擎对错误的容忍度远高于人眼。
一、变量一:拾音距离——决定性最大的一个
语音识别的准确率随距离衰减极快。距离每翻一倍,有效信噪比大约下降 6dB,对应转写准确率的下降远比想象中大(以下衰减曲线为示例测试数据,实测以厂商环境为准):
|
拾音距离 |
安静门店环境 |
嘈杂环境(客流高峰) |
|
0.5–1 米 |
97%+ |
93% |
|
2–3 米 |
96% |
90% |
|
4–5 米 |
92% |
84% |
|
6 米以上 |
85% 以下 |
不可用 |
这正是为什么工牌类产品普遍把有效拾音半径标在 5 米——这是业务可用的底线,而不是技术上限。佩戴位置(胸前领口 vs 口袋)带来的差异可达 3–5 个百分点,领口位置永远优于口袋。
二、变量二:环境噪声
门店背景噪声的三大来源:背景音乐、其他组客户交谈、店外街道。改善手段按有效性排序:
- 麦克风阵列降噪(硬件层,效果最好):双麦及以上的阵列可以做波束成形,把说话人方向以外的声音压低
- 前端降噪算法(软件层):对稳态噪声(音乐、空调)有效,对重叠人声效果有限
- 选址佩戴(管理层,零成本):接待区尽量避开音响正下方
一个可以问供应商的具体问题:"在 65dB 嘈杂环境下的实测准确率是多少?"——只报安静环境数字的,要么没测过,要么不敢报。
三、变量三:口音与方言
普通话标准口音下各家差距不大,真正的分水岭在方言:
- 带口音的普通话(川普、广普等):主流引擎可达 90–94%,日常业务可用
- 纯方言对话(客户和员工全程讲方言):通用引擎降到 80% 上下,必须确认供应商有方言专项优化,否则转写基本不可读
- 混合场景(普通话为主、夹杂方言词):95% 左右,个别方言词会错但不妨碍关键词命中
给采购的建议:让供应商拿你的门店真实录音做测试样本,而不是用它自带的演示音频。方言强相关的行业(区域零售、本地服务业)这一步不能省。
四、变量四:专业术语
通用引擎对行业术语的识别明显弱于垂直调优后的引擎——比如汽车行业的"HUD""CVT""置换补贴"、医美的"水光针""热玛吉"、金融的"增额终身寿",这些词在没有行业模型的引擎里经常被转成同音的无关词。改善路径:
- 热词配置:把你的产品名、品牌名、高频术语加进热词表,术语类错误通常能减少一半以上
- 行业模型:确认供应商是否有你所在行业的调优模型,没有的话热词就是你的全部手段
五、变量五:说话人分离(谁说了哪句)
销售场景里,分清"顾问说的"和"客户说的"比转写本身更重要——话术核查只看顾问的话,异议分析只看客户的话。两人对话的说话人分离准确率通常在 92–96%,受两点影响:
- 音量差:顾问和客户声音接近时分得更准,一边倒的音量反而难分
- 打断频率:频繁互相打断的对话分离错误率上升
评估时让供应商演示一段真实接待录音的分离结果,比看参数表有用。
六、变量六:上传与转写的实时性
实时性和准确率是两回事,但影响使用体验:分钟级上传 + 批量转写的方案,数据延迟半小时到几小时;边录边传、准实时转写的方案,接待结束后几分钟出结果。对"接待结束立刻复盘"的管理场景,这个差异很实际。传输链路上的差异(4G 独立联网 vs 依赖门店网络)同样影响数据完整性,选型时和准确率一起看。
七、怎么把准确率变成"够用":三步验收法
- 测真实场景:拿自己门店的录音(各种噪声、口音)做样本测试,不用供应商演示音频
- 按用途定标准:关键词命中/话术核查类用途,95% 即达标;需要全文精读的用途,要求 97% 以上并确认人工复核流程
- 验证分析层:转写准确率是手段,最终看分析结果对不对——"客户提到的竞品有没有被正确归类""异议有没有被正确识别"。分析层准了,业务才算闭环
对会话分析这一层怎么做的,可以进一步了解 DuDuAI 会话智能引擎的能力介绍;硬件采集端的参数(拾音距离、降噪方案)在 SX 系列智能语音工牌 与 SG 系列 4G 拾音工牌 的产品页有具体说明;整体方案与行业案例可在 DuDuTalk 官网 查看。
八、常见问题
Q1:96% 听起来很高,为什么我看到的转写稿还是有错? A:96% 意味着每 100 字错 4 个字,千字稿约 40 处错。人眼读起来"到处是错"是正常的——但关键词命中和话术核查看的是目标词,错在无关词上不影响业务结论。评估时看分析结果,别逐字读转写稿。
Q2:能不能先小规模测试再决定? A:应该,而且这是标准流程。用 2–3 家店、2 周真实录音做测试,重点看嘈杂时段和方言员工的表现,而不是理想环境。
Q3:转写错了能纠正吗? A:平台通常支持人工修正与热词补充。热词是系统性方案(一次配置长期生效),逐条人工修正只适合精读场景。
Q4:准确率和价格有关系吗? A:硬件价格差异主要在采集端(拾音、续航、工艺);转写引擎能力的差异体现在云端服务定价与模型版本。便宜到离谱的产品往往在引擎上省成本,测试时把嘈杂环境数据一跑就现形。